Comment les entreprises de logistique les plus performantes suivent la régularité de leur exécution en 2026
Comment les entreprises de logistique suivent-elles la régularité de leur exécution ? Pour la plupart des équipes opérationnelles, la réponse honnête est : pas suffisamment bien. Un réseau logistique régional peut mobiliser chaque jour des centaines de chauffeurs, répartiteurs, responsables d’entrepôt et managers de hubs. Malgré cette échelle, la plupart des équipes opérationnelles ne disposent d’aucun moyen fiable de savoir si l’exécution est réellement homogène sur l’ensemble du réseau avant qu’un problème ne survienne. Un rapport de livraison en retard arrive le vendredi. Une réclamation client tombe le lundi. À ce moment-là, l’écart à l’origine de ces deux problèmes se creuse déjà depuis plusieurs semaines.
Le problème fondamental est simple : les outils de reporting traditionnels montrent ce qui s’est déjà produit. Ils ne montrent pas ce qui est en train de dériver. C’est pourquoi un nombre croissant de responsables logistiques associent leurs systèmes TMS et ERP existants à des plateformes d’intelligence d’exécution comme PerkFlow, qui font apparaître les écarts en temps réel plutôt qu’après coup. Pour y parvenir, il faut les bons KPI, un flux de données fiable, des outils de visibilité adaptés et des seuils SLA clairement définis. Cet article présente l’ensemble de cette approche, ainsi qu’une checklist pratique pour commencer dès aujourd’hui à mesurer la régularité de l’exécution dans votre premier hub.
Comment suivre la régularité de l’exécution ? Commencez par le manque de visibilité
Le manque de visibilité dans les opérations distribuées
Votre hub de Dallas peut fonctionner avec un taux OTIF de 97 %. Votre hub d’Atlanta peut être à 88 %. La plupart des responsables des opérations ne découvriront pas cet écart avant qu’une réclamation client ne déclenche une analyse manuelle ou qu’une scorecard mensuelle ne soit constituée. Les écarts d’exécution se cachent dans des systèmes cloisonnés : le TMS contient les données d’expédition, le WMS conserve les données de précision du picking et la télématique enregistre les itinéraires des chauffeurs, mais aucun de ces systèmes ne communique nativement avec les autres. Vous vous retrouvez avec des fragments de vérité dispersés entre plusieurs plateformes, sans vue unique permettant d’identifier où la visibilité de la supply chain se dégrade réellement et où les indicateurs de performance des livraisons sortent de leur plage normale.
Les limites des audits manuels
Les méthodes traditionnelles comme les audits ponctuels programmés, les revues hebdomadaires des superviseurs et les relevés papier de fin de shift capturent un instantané, pas une tendance. Un hub faisant travailler 50 chauffeurs ou plus par shift ne peut pas compter sur l’observation manuelle pour détecter la dérive d’exécution avant qu’elle ne se transforme en dépassements de SLA et en érosion des revenus. Ces méthodes sont réactives par nature. Au moment où le cycle d’audit est terminé, les dégâts sont déjà là. Les opérations logistiques ont besoin d’un système de surveillance capable de signaler les écarts pendant qu’il est encore temps d’agir.
Les KPI qui signalent réellement la performance
Indicateurs de fiabilité du service et de qualité d’exécution
Le suivi de la régularité de l’exécution commence avec quatre KPI principaux : OTIF (on-time in-full), taux de livraison à l’heure, précision des commandes et taux de commandes parfaites. L’OTIF permet de mesurer si l’opération respecte régulièrement le niveau de service promis, en prenant en compte à la fois le respect des délais et l’intégralité de chaque livraison. Le taux de livraison à l’heure se concentre uniquement sur la fiabilité des délais. La précision des commandes mesure si les articles ont été préparés, emballés et expédiés sans erreur. Le taux de commandes parfaites est le plus complet des quatre : il vérifie simultanément qu’une livraison est arrivée à temps, complète, sans dommage et avec une documentation correcte.
Pour les objectifs de référence, un OTIF supérieur ou égal à 95 % est généralement considéré comme une performance solide dans la logistique aux États-Unis, les réseaux les plus performants visant 97 à 98 %, un seuil cité par des organisations du secteur de la supply chain telles que le CSCMP. Une précision des commandes de 98 à 99 % représente le niveau « excellent » pour les opérations de fulfillment. Des taux de livraison à l’heure compris entre 95 et 98 % indiquent une exécution fiable des délais. Si l’un de ces indicateurs de performance des livraisons reste régulièrement inférieur à 90 %, cela constitue le signe de problèmes d’exécution systémiques plutôt que d’incidents isolés.
KPI d’efficacité et d’exception
Au-delà des indicateurs de service principaux, quatre KPI supplémentaires permettent de comprendre la régularité réelle de vos opérations. Le temps d’attente sur site (dwell time) et le temps de rotation des camions mesurent le temps passé par les véhicules dans une installation, révélant les inefficacités de chargement, de déchargement et de mise en attente qui peuvent varier selon le hub et le shift. Le taux de livraison réussie dès la première tentative indique à quelle fréquence l’exécution aboutit sans reprise ni traitement d’exception.
Le taux d’exception est l’un des signaux les plus directs de la régularité opérationnelle : il mesure la proportion de commandes ou d’expéditions affectées par des retards, des réacheminements, des annulations ou des dommages. Le respect des SLA et des rendez-vous, ainsi que la conformité des preuves de livraison, servent d’indicateurs de discipline des processus. Ils permettent de déterminer si vos équipes suivent le processus défini ou improvisent pour contourner les contraintes, une distinction qui peut rapidement se multiplier à l’échelle d’un réseau distribué.
Comment construire un flux de données des systèmes sources vers un tableau de bord unifié
Connecter vos sources de données
Une surveillance fiable de l’exécution commence par une compréhension précise de l’emplacement réel de vos données. Les entreprises de logistique s’appuient généralement sur quatre grandes sources d’événements : les plateformes TMS (SAP TM, Oracle OTM, Blue Yonder) pour les données d’expédition et d’itinéraire ; les systèmes WMS pour les événements de picking, de packing et de quai ; les fournisseurs de télématique et d’IoT comme Samsara, Motive et Geotab pour les données en temps réel sur les véhicules et les actifs ; et les flux EDI ou API provenant des transporteurs, des 3PL et des partenaires commerciaux. Chacune de ces sources génère des événements d’exécution dans des formats différents, à des fréquences différentes et avec des niveaux de complétude variables. Le problème n’est pas d’accéder aux données. Il consiste à faire communiquer ces signaux entre eux de manière à fournir une véritable visibilité sur la supply chain.
Normaliser les événements dans une vue unique
L’architecture d’intégration suit généralement un schéma cohérent : les flux provenant des systèmes sources sont envoyés vers un event broker (Kafka est un choix courant), les événements sont normalisés selon un modèle de données commun, puis les données préparées sont envoyées vers un data warehouse ou un tableau de bord opérationnel. Pour que ce fonctionnement soit fiable, plusieurs contrôles pratiques doivent être mis en place :
- La déduplication empêche les nouvelles tentatives d’envoi de créer des événements fantômes.
- Les contrôles de latence détectent les signaux manquants des transporteurs avant qu’ils ne créent des angles morts.
- La correspondance des données de référence rapproche les identifiants d’expédition et les codes des sites entre les différents systèmes afin que les événements provenant de plusieurs plateformes soient associés au même objet métier.
- Les pistes d’audit conservent les horodatages provenant des systèmes sources pour le suivi et la vérification de la conformité aux SLA.
Même un tableur bien structuré peut servir de couche de consolidation lorsque vous débutez. L’objectif est d’obtenir une vue unique de l’exécution par hub, équipe et rôle, alimentée de manière cohérente par les données sources.
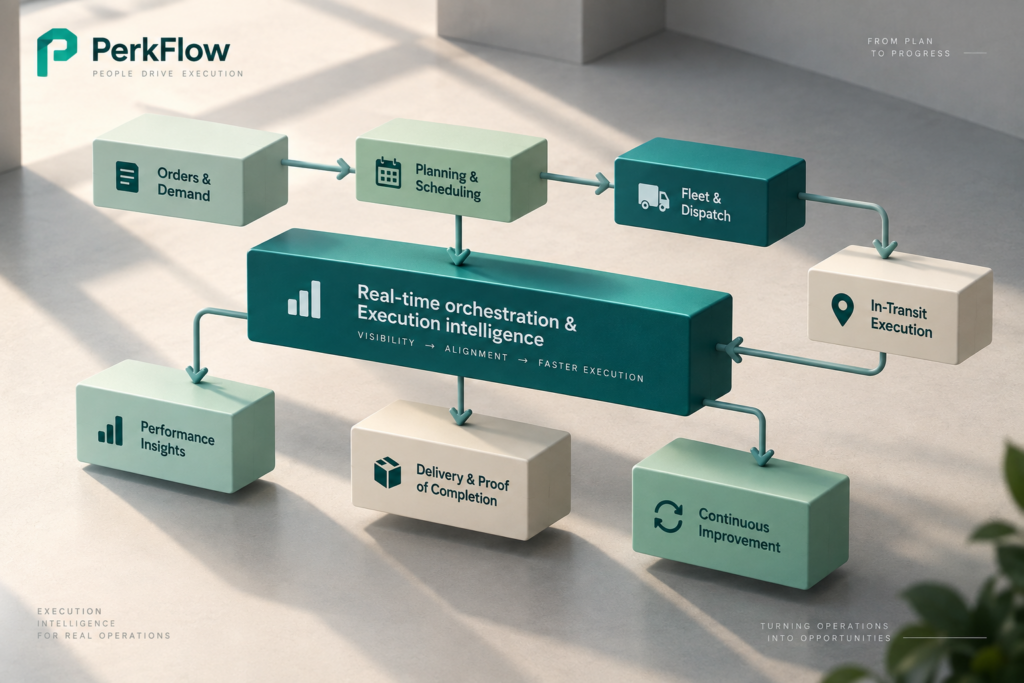
Les outils utilisés par les responsables logistiques pour suivre la régularité de l’exécution
TMS et plateformes de visibilité
Les plateformes TMS d’entreprise comme SAP TM, Oracle OTM, Blue Yonder et Descartes gèrent efficacement la planification du transport et les données d’exécution. Les plateformes de visibilité du fret en temps réel comme project44 et FourKites fournissent un suivi des expéditions au niveau des transporteurs. Ces outils répondent efficacement au besoin de visibilité de bout en bout et constituent une base solide pour toute opération logistique. En revanche, ils n’agrègent pas les écarts d’exécution entre les hubs, les équipes de chauffeurs et les différents rôles opérationnels dans une même vue. Vous pouvez voir qu’une expédition est en retard, mais pas qu’un hub présente un taux d’exception trois fois supérieur à celui d’un autre, ou qu’une équipe de répartiteurs ne respecte systématiquement pas les seuils SLA.
La couche d’intelligence d’exécution
C’est précisément l’écart que des plateformes comme PerkFlow sont conçues pour combler. PerkFlow s’intègre à vos outils logistiques et de travail, récupère les signaux d’exécution provenant de l’ensemble de votre stack et fait apparaître les écarts en temps réel par hub, équipe ou rôle. Contrairement à un tableau de bord BI qui montre ce qui s’est produit le mois dernier, il détecte la dérive d’exécution au moment où elle se produit, donnant aux responsables des opérations le temps nécessaire pour corriger un problème de régularité avant qu’il ne devienne un dépassement de SLA. Pensez-y comme à une couche d’OS opérationnel : une vue unifiée et en temps réel permettant de voir où l’exécution reste stable et où elle commence à dériver.
Pour les réseaux logistiques distribués, ce niveau de régularité opérationnelle n’est pas facultatif. C’est ce qui distingue les opérations capables de détecter rapidement les problèmes de celles qui ne les découvrent qu’à travers une réclamation client.
Standardisation des processus et seuils SLA pour prévenir la dérive d’exécution
Intégrer le standard au fonctionnement de vos opérations
Le suivi de la régularité de l’exécution n’est utile que si vous disposez d’un standard défini auquel la comparer. Les opérateurs logistiques utilisent une séquence cohérente pour réduire les écarts : cartographier les workflows principaux (réception, dispatch, libération des expéditions, gestion des exceptions), puis documenter les variations de fonctionnement actuelles selon les sites et les shifts. À partir de là, rédigez des SOP avec des séquences d’étapes et des critères de passation précis, puis testez-les dans un hub avant de les déployer à plus grande échelle. Le standard doit être intégré directement au système, grâce aux champs obligatoires du TMS et du WMS, aux règles de routage et aux contrôles de statut, afin que les équipes ne puissent pas le contourner par habitude ou au moyen de solutions de contournement. Si le système permet un raccourci, les opérateurs expérimentés le trouveront. Intégrez la conformité aux processus dans l’outil, pas dans l’espoir qu’elle soit respectée.
Définir les seuils d’alerte SLA
Les seuils d’alerte doivent prévenir les équipes lorsque les KPI commencent à dériver, et non une fois qu’ils ont déjà échoué. Un framework pratique utilise trois niveaux pour chaque indicateur : une cible, un seuil d’avertissement et un seuil critique.
Pour l’OTIF, cela pourrait correspondre à 95 % comme objectif, 92 % comme niveau d’avertissement déclenchant une alerte au superviseur et 88 % comme niveau critique entraînant une escalade vers la direction. L’objectif est de créer des fenêtres d’intervention : lorsqu’un hub franchit le seuil d’avertissement, il reste encore du temps pour analyser et corriger la cause racine avant que l’indicateur n’atteigne son niveau critique. Des cycles d’audit réguliers et des analyses des causes racines permettent d’éviter que le standard ne dérive avec le temps, à mesure que la composition des équipes, les itinéraires et les volumes évoluent.
Checklist pratique pour commencer à suivre la régularité de l’exécution dès aujourd’hui
La séquence de mise en place
Les étapes suivantes permettent de passer de l’absence de visibilité à un système fonctionnel de suivi de l’exécution. Suivez-les dans l’ordre, chaque étape s’appuyant sur la précédente.
- Sélectionnez 5 à 7 KPI essentiels pour votre opération : l’OTIF, la précision des commandes, le taux d’exception, le temps d’attente sur site et le taux de livraison réussie dès la première tentative constituent un bon point de départ.
- Auditez vos sources de données actuelles : identifiez les systèmes qui enregistrent chaque événement lié à vos KPI et dans quel format.
- Cartographiez le flux de données entre vos systèmes sources et une couche de consolidation. Un tableur constitue un point de départ tout à fait valable.
- Définissez des objectifs de référence adaptés au secteur pour chaque KPI, en fonction de la complexité de votre réseau et des exigences de vos SLA clients.
- Définissez les seuils SLA (objectif, avertissement, critique) pour chaque indicateur et attribuez un responsable à chaque niveau d’alerte.
- Configurez un tableau de bord ou outil de visibilité affichant les performances par hub, groupe de chauffeurs et équipe.
- Lancez un pilote de deux semaines dans un hub, comparez les résultats aux références et identifiez les principales sources d’écart.
- Standardisez le processus dans les autres hubs à l’aide de SOP, de contrôles système et de cycles d’audit réguliers.
Prêt à voir comment PerkFlow fait apparaître les écarts d’exécution en temps réel ? Planifiez une démonstration avec l’équipe PerkFlow.
Que faire une fois le suivi en place ?
La mesure seule ne permet pas de corriger les écarts d’exécution. Une fois votre système de surveillance opérationnel, l’étape suivante consiste à mettre en place une boucle de feedback : analyser chaque semaine les écarts au niveau des hubs, transmettre les informations aux superviseurs concernés et utiliser les données d’exécution pour orienter le coaching, la formation et les mises à jour des processus. Un rapport qui reste dans un tableau de bord sans être consulté n’est que du bruit. La valeur apparaît lorsque la bonne personne reçoit le bon signal au bon moment et sait exactement quoi en faire. C’est là que la différence concrète entre un outil de reporting et une plateforme d’intelligence d’exécution devient visible dans les opérations quotidiennes.
Une exécution régulière est un système, pas un objectif
Comprendre comment les entreprises de logistique suivent la régularité de leur exécution repose sur quatre éléments qui doivent fonctionner ensemble : les bons KPI, un flux de données fiable provenant des systèmes sources existants, des outils capables de faire apparaître les écarts en temps réel et des contrôles de processus empêchant la dérive de se multiplier avant que quiconque ne la remarque. Les entreprises qui réussissent sur ce point ne disposent pas nécessairement des stacks technologiques les plus sophistiquées. Elles savent ce que signifie une exécution régulière dans chaque hub, disposent d’un système capable de signaler les écarts avant qu’ils ne deviennent des violations de SLA et ont une équipe qui sait exactement quoi faire lorsque les indicateurs évoluent.
PerkFlow rend cette clarté opérationnelle accessible sans vous obliger à revoir complètement les outils déjà en place. La plateforme se superpose à votre TMS, ERP et plateformes de communication existants afin de fournir une vue unifiée et en temps réel des endroits où l’exécution reste stable et de ceux où elle commence à dériver. Commencez par un hub. Sélectionnez vos KPI essentiels. Examinez honnêtement où se cachent réellement vos écarts d’exécution. C’est suffisant pour commencer à construire.
Pour visualiser la régularité de l’exécution en temps réel à l’échelle de votre réseau, planifiez une démonstration avec l’équipe PerkFlow.
 Écrit par Steve Mbenoun